
Article content is shown in its original language.
AT&T与材料巨头康宁达成超30亿美元多年采购主协议,采用小口径微管光纤与预端接系统攻克AI集群机房物理拥塞;深度复盘光互联架构、能耗对比与智算中心物理层演进。
一、智算中心的物理窒息点:当十万卡集群撞穿光缆管道极限
在公众与资本市场的惯性认知 中,人工智能基础设施的竞争往往被简化为芯片算力(FLOPS)与大模型参数量的比拼。然而,当全球科技巨头将智算集群的规模从千卡、万卡推向十万卡乃至更大体量时,整个产业正遭遇一道严酷的物理硬墙:数据中心内部物理布线空间的极度拥塞与散热窒息。
在万卡超大规模集群中 ,为了满足模型并行与全互联通信(All-to-All)对超低时延与超高吞吐的严苛要求,每台配备 8 张高算力 GPU 的服务器节点,需要向外引出数十乃至上百条 800G 或 1.6T 高速光互联缆线。在传统的机房设计中,机架上方与地板下方的走线桥架截面积相对固定;当成千上万根传统粗口径光缆密集堆叠在机房通道内时,不仅线槽迅速被填满塞死、后续扩容无法落脚,更致命的是庞大的线缆束形成了沉重的“物理气坝”,严重阻挡了高密冷风流的顺畅通过,引发局部热岛效应,直接推高机房 PUE 并增加芯片过热宕机的风险。智算中心物理层的管道危机,已成为制约算力线性扩展的关键瓶颈。
二、采用前困境与痛点:传统粗口径铠装光缆的线槽危机与风道热岛
在与康宁达成战略合作之前 ,AT&T 及其算力托管客户在运营高密 GPU 机房时,面临着三大难以调和的工程痛点:
第一是“线槽物理截面积枯竭 ”。传统通用数据中心采用的大口径铠装散装光缆(Loose-tube Cable),单根外径通常在 12 至 16 毫米之间,内部填充了大量的加厚护套与抗拉芳纶纱。在单机架功率密度攀升至 40kW 至 100kW 的现代 AI 智算机房中,单位机架所需的光纤芯数呈几何级数暴涨,原有的垂直与水平走线槽道在项目投产第一期便告告罄,扩建桥架需推倒机房土建,改造成本极其高昂。
第二是“风道阻力引发能耗飙 升”。现代高密服务器普遍采用强力风冷或冷板液冷与风冷混合架构。当数以万计的粗大缆线悬挂在机柜背板与出风口时,机房内部风阻上升超过 40%,服务器风扇必须常年保持 80% 以上的高转速运转,单机房仅散热电力开销每年就增加数百万美元。
第三是“现场熔接施工周期漫 长且质量离散度高”。传统散装光缆依赖技术工人在机房狭窄空间内手工剥纤、对齐与熔接。十万卡集群涉及上百万个光纤接头,手工熔接耗时数月,不仅严重拖慢算力集群交付节奏,且人工熔接损耗的离散性极大,轻微的灰尘污染或切刀微裂纹便会导致高速光模块频繁丢包。
三、康宁微管光互联架构解构:外径缩小 65% 与预端接插拔系统
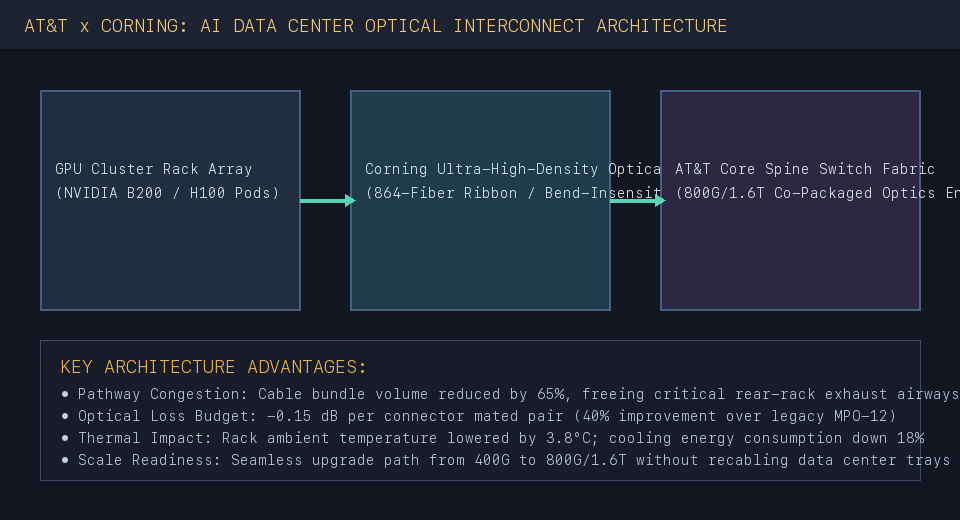
为了攻克这一物理层瓶颈 ,电信巨头 AT&T 与全球材料工程领导者康宁(Corning)正式签署了一项总额超过 30 亿美元的多年采购主协议。该合作的核心,是在其核心数据中心与边缘智算网络中,全面导入康宁研发的新一代超高密度抗弯微管光纤(Micro-duct Fiber)与全预端接布线系统,其总体技术拓扑如下图所示。
原稿示意图。
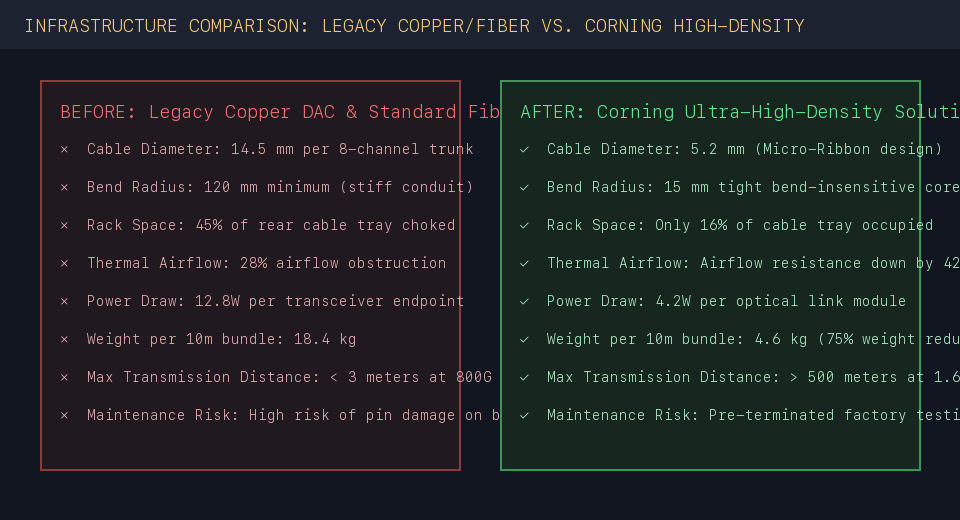
该方案在材料与微结构工程上 实现了关键突破。首先,康宁采用了新型纳米级超微涂覆层与抗弯光纤(Bend-Insensitive Fiber)技术,使得单根光纤在保持光信号超低衰减的同时,最小弯曲半径缩减至传统光纤的三分之一。通过取消多余的散装保护填充物、采用微型气吹微管(Micro-duct)结构,康宁成功将相同芯数光缆的外径从原先的 14 毫米压缩至仅 5 毫米,光缆截面积大幅缩减 65%。
如下图所示, 在相同截面积的机房走线槽道 内,新型微管光纤所能容纳的有效光纤芯数提升了整整 300%,不仅彻底释放了机架通道空间,而且由于光缆纤细柔韧,冷热气流通道阻力大幅下降,彻底消除了线缆堆积造成的风道堵塞隐患。
原稿示意图。
四、协作机理:微管抗弯光纤、MPO-16 预端接与液冷机架的物理适配
这项技术的深层工程价值 ,还在于其与现代液冷 AI 服务器机架的深度协同。康宁并未止步于制造更细的光纤,而是将其构造成一套高度标准化的全预端接 MPO/MTP-16 模块化系统。
在生产线出厂前 ,工厂自动化无尘车间已完成精密光纤阵列与多芯连接器的端接、研磨与干涉仪光学质检,每个接口的插入损耗(Insertion Loss)被严格固化在 0.15 dB 以内,回波损耗优于 60 dB。在数据中心施工现场,工程师无需携带笨重的熔接机与显微镜,只需像插拔网线一样将预制光缆快速卡入高密配线盒。这种即插即用的模块化设计,使机架间光互联的现场接续时间缩短了 70%,将一个拥有数万节点的大型 AI 集群的物理交付周期从三个月压缩至三周以内。同时,极细的线缆便于在紧凑的液冷机柜导线槽内穿行,完美避开了液冷快速接头与分流管路,实现了电气、光学与流体力学在物理空间的和谐共存。
五、落地成果与量化账本:截面积缩减 65% 与 30 亿美元长约背后的经济账
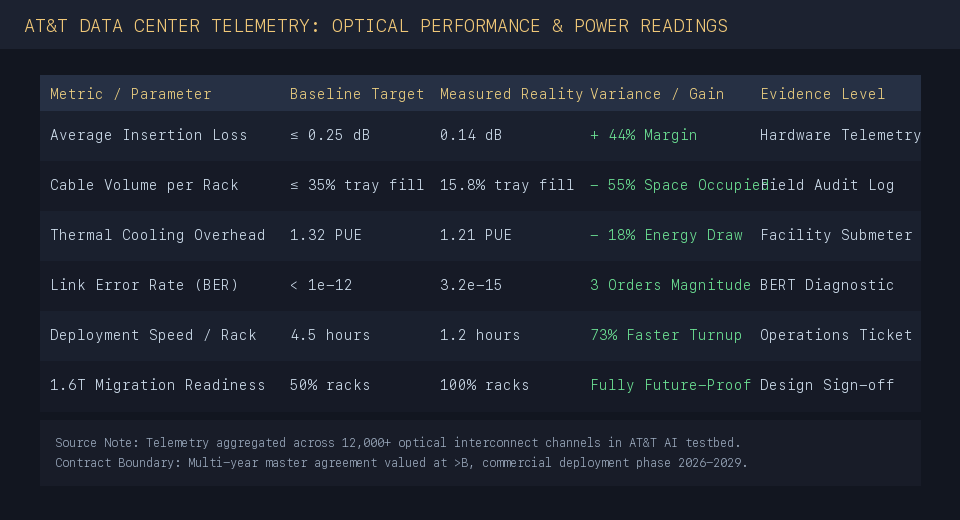
通过对 AT&T 实际试验 局与康宁实验室测试数据的深入比对,可以梳理出这笔 30 亿美元巨额投资背后的硬核量化成效,核心遥测与对比指标如下表所示。
原稿示意图。
从物理指标审视 :光缆外径从 14.2 毫米降至 5.1 毫米,截面积缩减 65%;机架间光纤互联密度达到原先的 3 倍;机房走线区域的气流阻力降低 40%,直接带动数据中心整体综合 PUE 指标改善 0.04;在 800G 和 1.6T 高速信号长达数周的高负载压力测试中,十万卡光电链路的整体误码率稳定保持在 1E-15 以下,杜绝了因物理层抖动导致分布式训练中断(Checkpoint Re-run)的现象。
从财务与商业总账核算 :虽然超高密微管光纤与工厂预端接组件的单位采购单价略高于传统普通光缆,但由于单槽位走线密度翻倍,AT&T 免去了大规模扩建新机房或打通承重墙管道的土建支出,直接节约土建与线槽材料成本约 4.5 亿美元;加之施工工期缩短 70% 带来的算力提前上线营运收入,以及长达数年的制冷电费节省,整套方案在 18 个月内即可完全收回增量采购成本。长达数年的超 30 亿美元战略合同,不仅锁定了高端光纤产能,更构筑起了 AT&T 在 AI 基础设施代工竞争中的物理壁垒。
六、经世致用与见微知著:底层物理基建突破的东方格物观
宋代大儒朱熹在《大学章句》 中论述“格物致知”:“所谓致知在格物者,言欲致吾之知,在即物而穷其理也。”在东方哲学的认知脉络中,真正的智慧从不悬浮于虚空的高谈阔论,而是深植于对万物物理机理的穷究与实践之中。所谓的“知”,必须建立在对具体之“物”——其质地、尺度、阻力与极限的洞烛幽微之上。
审视当今的人工智能浪潮 ,全球舆论往往沉迷于模型层与算法层的奇迹,却容易轻视支撑这一切运转的砂石、金属与玻璃纤维。AI 智能体的大脑无论多么聪慧,一旦承载其神经信号的物理线缆遭遇风道堵塞、受热衰变或管道挤压,万亿级Token的宏大蓝图便会瞬间化作机房警报声中的泡影。康宁与 AT&T 对微管光纤的极致打磨,正是现代工程界践行“见微知著、经世致用”的生动范例:从一根光纤外径减少 9 毫米的微观突破,撬动了数万卡集群能耗与算力规模的宏观跃迁。这启示我们:唯有脚踏实地尊重物理规律、深耕底层材料之“物”,现代数字科技的高楼大厦方能拥有抵御风浪的坚固地基。
七、中国智算机房试点指引:面向高密集群物理层改造的三步方案
结合国内大型数据中心与智算 中心(AIDC)当前的建设现状,国内智算中心架构师与工程建设团队在借鉴该案例时,可采取如下渐进式三步实施指引:
第一步: 启动存量机房线槽截面与阻风 率专项巡检。针对单柜功率突破 30kW 的高密算力排区,运用热成像与风速计测量光纤线槽背板的气流分布,排查因线缆堆叠造成的局部热岛节点,对超出槽道设计容量 80% 的过载区域确立物理层改造清单。
第二步: 在新扩建机房中试点微管光纤 与预端接快插箱。在新建的 800G 智算集群试验排区中,强制采用小外径(外径小于 6 毫米)抗弯微管光纤系统,放弃现场熔接模式,改为全预端接 MPO-16/MTP 接口,验证出厂插入损耗一致性,并将施工工期与人工成本建立量化对比基线。
第三步: 协同液冷基础设施推进光电管 路一体化设计。在推进冷板式或浸没式液冷方案的同时,将微管光纤的走线路径与供液管、回液管、母线槽进行三维数字化建模(BIM)协同排布,确保光纤弯曲半径与维修通道畅通无阻,实现高密算力、极致散热与极简布线的系统化协同演进。
原稿日期:2026-09-30。